
فرض کنید صاحب یک فروشگاه اینترنتی ووکامرسی هستید. یک روز صبح وارد گوگل سرچ کنسول میشوید و با تعجب میبینید که صدها صفحه مثل سبد خرید، فیلترهای محصول و صفحات پرداخت در نتایج جستجوی گوگل ایندکس شدهاند. این یعنی محتوای بیارزش برای کاربر، اتلاف Crawl Budget و در بدترین حالت، افت رتبه سئوی کل سایت.
این مشکل معمولاً از یک نقطه شروع میشود: عدم آشنایی صحیح با فایل robots.txt و Robot Meta Tags. بسیاری از مدیران سایت وردپرسی این دو مفهوم را با هم اشتباه میگیرند یا اصلاً نمیدانند چطور باید آنها را تنظیم کنند.
در این راهنمای جامع، قدم به قدم یاد میگیرید که فایل robots.txt چیست، چطور آن را در وردپرس تنظیم کنید، تفاوت Noindex و Nofollow در چیست، و چطور در افزونههای RankMath و Yoast SEO تنظیمات Robot Meta را به درستی پیکربندی کنید. در پایان این مقاله، کنترل کامل ایندکس شدن صفحات سایتتان را در دست خواهید داشت.
فایل Robots.txt چیست و چه کاربردی دارد؟
تعریف Robots.txt به زبان ساده
فایل robots.txt یک فایل متنی ساده است که در ریشه (root) دامنه سایت شما قرار میگیرد. آن را معمولاً در آدرسی مثل yoursite.com/robots.txtمیتوانید پیدا کنید. این فایل مجموعهای از دستورالعملها برای رباتهای موتورهای جستجو (مثل Googlebot) است که مشخص میکند کدام بخشهای سایت باید کرال (crawl) شوند و کدام بخشها نباید.
به زبان ساده، robots.txt مثل یک تابلوی راهنما در ورودی سایت شماست که به رباتها میگوید: «از این مسیر برو، از آن مسیر نرو».
چرا Robots.txt برای سئو مهم است؟
مدیریت درست robots.txt چند مزیت مستقیم برای سئوی سایت دارد:
- مدیریت Crawl Budget: گوگل برای هر سایت بودجه محدودی برای کرال کردن صفحات در نظر میگیرد. با بلاک کردن صفحات بیارزش (مثل صفحات ادمین یا فیلترهای محصولات فروشگاه)، این بودجه صرف صفحات مهم میشود.
- جلوگیری از کرال محتوای تکراری: در فروشگاههای ووکامرسی، صفحات فیلتر و مرتبسازی میتوانند هزاران URL تکراری تولید کنند. (قبل از فاجعه جلوی این مورد باید گرفته بشه)
- محافظت از منابع سرور: کرال بیش از حد رباتها میتواند فشار غیرضروری روی سرور ایجاد کند.
تفاوت Robots.txt با Robot Meta Tags
این نکته کلیدیترین بخش این مقاله است، پس با دقت بخوانید:
- Robots.txt پیش از کرال عمل میکند. اگر صفحهای در Robots.txt بلاک شود، ربات گوگل اصلاً وارد آن صفحه نمیشود.
- Robot Meta Tags بعد از کرال عمل میکند. یعنی ربات وارد صفحه میشود، محتوا را میخواند، اما بر اساس دستور Meta Robots تصمیم میگیرد که آن را در نتایج جستجو نمایش دهد یا نه.
این تفاوت به ظاهر ساده، اشتباهات بزرگی در سئوی بسیاری از سایتها ایجاد کرده است که در ادامه به آن میپردازیم.
ساختار فایل Robots.txt و دستورات اصلی
فایل robots.txt از چند دستور اصلی تشکیل شده که هرکدام نقش مشخصی دارند.
دستور User-agent
این دستور مشخص میکند قوانین بعدی برای کدام ربات اعمال شود. برای اعمال قانون به همه رباتها از ستاره (*) استفاده میشود:
User-agent: *اگر بخواهید قانون خاصی فقط برای Googlebot اعمال شود:
User-agent: Googlebotدستور Disallow
این دستور مشخص میکند کدام مسیرها نباید کرال شوند:
Disallow: /wp-admin/
Disallow: /cart/
Disallow: /checkout/
دستور Allow
در مقابل Disallow، دستور Allow اجازه دسترسی به مسیر خاصی را میدهد؛ حتی اگر در مسیر بالاتری Disallow شده باشد:
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
دستور Sitemap
مسیر فایل Sitemap XML سایت را به رباتها معرفی میکند، بهتر است همیشه این دستور برای تازه نگه داشتن محتوا بر روی فایل قرار داده شود.
Sitemap: https://yoursite.com/sitemap_index.xmlفایل robots.txt استاندارد
باکس کد زیر نمایانگر یک نمونه robot.txt استاندارد برای سایت وردپرسی است:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /wp-includes/
Disallow: /?s=
Disallow: /search/
Sitemap: https://yoursite.com/sitemap_index.xml
Robot Meta Tags چیست؟

تعریف Robot Meta Tags
Robot Meta Tags دستوراتی هستند که در بخش <head> هر صفحه قرار میگیرند و به موتورهای جستجو میگویند چگونه با آن صفحه رفتار کنند. این تگها شامل دستوراتی مثل index, noindex, follow و nofollow هستند.
نمونه یک تگ meta robots:
<meta name="robots" content="noindex, follow" />این دستور به ربات میگوید: «این صفحه را در نتایج جستجو نشان نده (noindex)، اما لینکهای داخل آن را دنبال کن (follow)».
تفاوت اساسی با robots.txt
تفاوت کلیدی این است:
- robots.txt: قبل از ورود ربات به صفحه، دسترسی را مسدود میکند. ربات اصلاً محتوای صفحه را نمیبیند.
- Robot meta tags: ربات وارد صفحه میشود، محتوا را میخواند، سپس تصمیم میگیرد آن را Index کند یا نه.
این تفاوت باعث میشود که اگر یک صفحه را همزمان در robots.txt بلاک کنید و هم در آن noindex بگذارید، گوگل نمیتواند تگ noindex را ببیند و ممکن است صفحه همچنان در نتایج باقی بماند.
کدام یکی را باید استفاده کنیم؟
قاعده کلی این است:
- اگر میخواهید ربات اصلاً وارد بخشی از سایت نشود (مثل پوشه wp-admin)، از robots.txt استفاده کنید.
- اگر میخواهید ربات محتوا را بخواند اما صفحه را Index نکند (مثل صفحات سبد خرید)، از noindex استفاده کنید.
- در بیشتر موارد ووکامرسی، ترکیب هر دو روش بهترین نتیجه را میدهد.
تفاوت Noindex و Nofollow
Noindex چیست و چه زمانی استفاده میشود؟
Noindex به موتور جستجو میگوید این صفحه را در نتایج نمایش نده. اما ربات میتواند لینکهای داخل صفحه را دنبال کند و به صفحات دیگر برود.
کاربردهای Noindex:
- صفحات سبد خرید و Checkout
- صفحات فیلتر و مرتبسازی محصولات
- صفحات نتایج جستجوی داخلی سایت
- صفحات Thank You بعد از خرید
- صفحات ورود و ثبتنام
- صفحات آرشیو نویسنده (در سایت تکنویسنده)
Nofollow چیست و کاربردهای آن
Nofollow به ربات میگوید لینکهای داخل این صفحه را دنبال نکند. این دستور معمولاً کمتر استفاده میشود و بیشتر برای لینکهای خارجی (در تگ <a>) کاربرد دارد.
کاربردهای Nofollow در سطح صفحه:
- صفحات با لینکهای تبلیغاتی زیاد
- صفحات نظرات کاربران (در صورت اسپم)
- صفحات موقت یا تست
ترکیبهای مختلف (Index,Follow / Noindex,Nofollow و…)
چهار حالت اصلی وجود دارد:
index, follow→ صفحه را Index کن و لینکها را دنبال کن (حالت پیشفرض)noindex, follow→ صفحه را Index نکن اما لینکها را دنبال کن (معمولترین حالت)index, nofollow→ صفحه را Index کن اما لینکها را دنبال نکن (نادر)noindex, nofollow→ نه Index کن نه لینکها را دنبال کن (صفحات حساس)
جدول مقایسهای
| دستور | معنی | کاربرد | مثال |
|---|---|---|---|
| index | صفحه در نتایج نمایش داده شود | صفحات اصلی سایت | صفحه محصول، مقالات وبلاگ |
| noindex | صفحه در نتایج نمایش داده نشود | صفحات داخلی بدون ارزش سئو | سبد خرید، فیلترها |
| follow | لینکهای صفحه دنبال شوند | صفحاتی که لینک به محتوای مهم دارند | صفحه دستهبندی |
| nofollow | لینکهای صفحه دنبال نشوند | صفحات با لینکهای نامعتبر | صفحه نظرات اسپم |
تنظیمات Robots.txt در وردپرس
چطور به فایل robots.txt دسترسی پیدا کنیم؟
وردپرس به صورت پیشفرض یک فایل robots.txt مجازی تولید میکند. برای دسترسی به آن:
- آدرس
yoursite.com/robots.txtرا در مرورگر باز کنید - اگر فایلی نمایش داده شد، وردپرس به صورت خودکار آن را مدیریت میکند
- اگر خطای 404 دریافت کردید، باید فایل را دستی ایجاد کنید
ویرایش دستی یا استفاده از افزونه
دو روش برای مدیریت robots.txt در وردپرس وجود دارد:
روش ۱: ویرایش دستی
- با FTP یا File Manager هاست، وارد ریشه سایت شوید (معمولا پوشه public_html)
- فایل
robots.txtرا ایجاد یا ویرایش کنید
مزیت: کنترل کامل
معایب: نیاز به دانش فنی، احتمال خطا بالاست
روش ۲: استفاده از افزونههای سئو
افزونههایی مثل RankMath و Yoast SEO ویرایشگر robots.txt دارند
مزیت: رابط کاربری ساده، کمتر احتمال خطا
معایب: اگر افزونه غیرفعال شود، تنظیمات از بین میرود
توصیه: برای اکثر کاربران، استفاده از افزونههای سئو امنتر و راحتتر است.
اگر از افزونه Yoast SEO استفاده میکنید، تنظیمات مربوط به فایل robots.txt را میتوانید از آدرس زیر پیدا کنید:
https://yoursite.com/wp-admin/admin.php?page=wpseo_tools&tool=file-editorاگر از افزونه RankMath استفاده میکنید، تنظیمات مربوط به فایل robots.txt را میتوانید از آدرس زیر پیدا کنید:
https://yoursite.com/wp-admin/admin.php?page=rank-math-options-general&view=robotsنمونه تنظیمات برای سایت وردپرسی
برای یک وبلاگ یا سایت خبری وردپرسی:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /wp-includes/
Disallow: /wp-content/plugins/
Disallow: /wp-content/themes/
Disallow: /?s=
Disallow: /author/
Sitemap: https://yoursite.com/sitemap_index.xml
نمونه تنظیمات برای فروشگاه ووکامرس
برای فروشگاه اینترنتی، تنظیمات پیچیدهتر است:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /cart/
Disallow: /checkout/
Disallow: /my-account/
Disallow: /?add-to-cart=
Disallow: /*?orderby=
Disallow: /*?filter_
Disallow: /shop/?
Sitemap: https://yourstore.com/sitemap_index.xml
توضیح: در این تنظیمات، صفحات سبد خرید، Checkout، فیلترهای محصول و پارامترهای مرتبسازی بلاک شدهاند تا Crawl Budget هدر نرود.
تنظیمات Robot Meta در افزونه RankMath
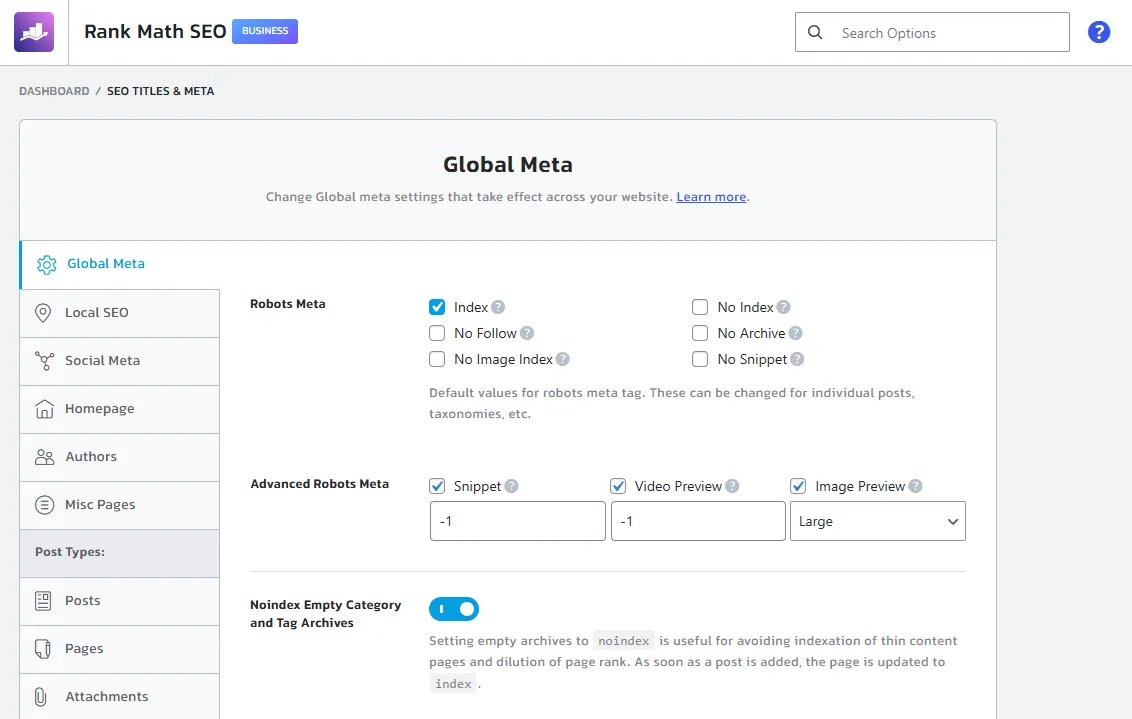
افزونه RankMath یکی از محبوبترین ابزارهای سئو در وردپرس است که کنترل دقیقی روی Robot Meta Tags ارائه میدهد.
فعالسازی تنظیمات Robot Meta
برای دسترسی به تنظیمات از پنل وردپرس وارد RankMath → Titles & Meta شوید.
https://yoursite.com/wp-admin/admin.php?page=rank-math-options-titles&view=globalتنظیمات سراسری (Global Settings)
در بخش Global Meta، تنظیمات پیشفرض برای کل سایت مشخص میشود. معمولاً حالت Index, Follow برای صفحات اصلی انتخاب میشود.
تنظیمات برای هر نوع محتوا (Post Types)
RankMath اجازه میدهد برای هر نوع محتوا جداگانه تنظیم کنید:
- Posts (نوشتهها): معمولاً
Index, Follow - Pages (برگهها): معمولاً
Index, Follow - Products (محصولات ووکامرس):
Index, Follow - Media (فایلهای رسانه): معمولاً
Noindex
مسیر: RankMath → Titles & Meta → Posts/Pages/Products و سپس تنظیم گزینه Robots Meta.
تنظیم Robot Meta برای تکتک صفحات
یکی از قابلیتهای کلیدی RankMath، امکان override تنظیمات سراسری برای هر صفحه به صورت جداگانه است:
- وارد ویرایش هر پست یا صفحه شوید
- در باکس RankMath (پایین یا کنار صفحه ویرایشگر)، به تب Advanced بروید
- گزینه Robots Meta را پیدا کنید
- تیک No INDEX یا No Follow را بر اساس نیاز فعال کنید
این قابلیت بهخصوص برای صفحات خاص ووکامرس مثل صفحه Checkout یا Thank You بسیار کاربردی است.
تنظیمات Robot Meta در افزونه Yoast SEO
مسیر دسترسی به تنظیمات
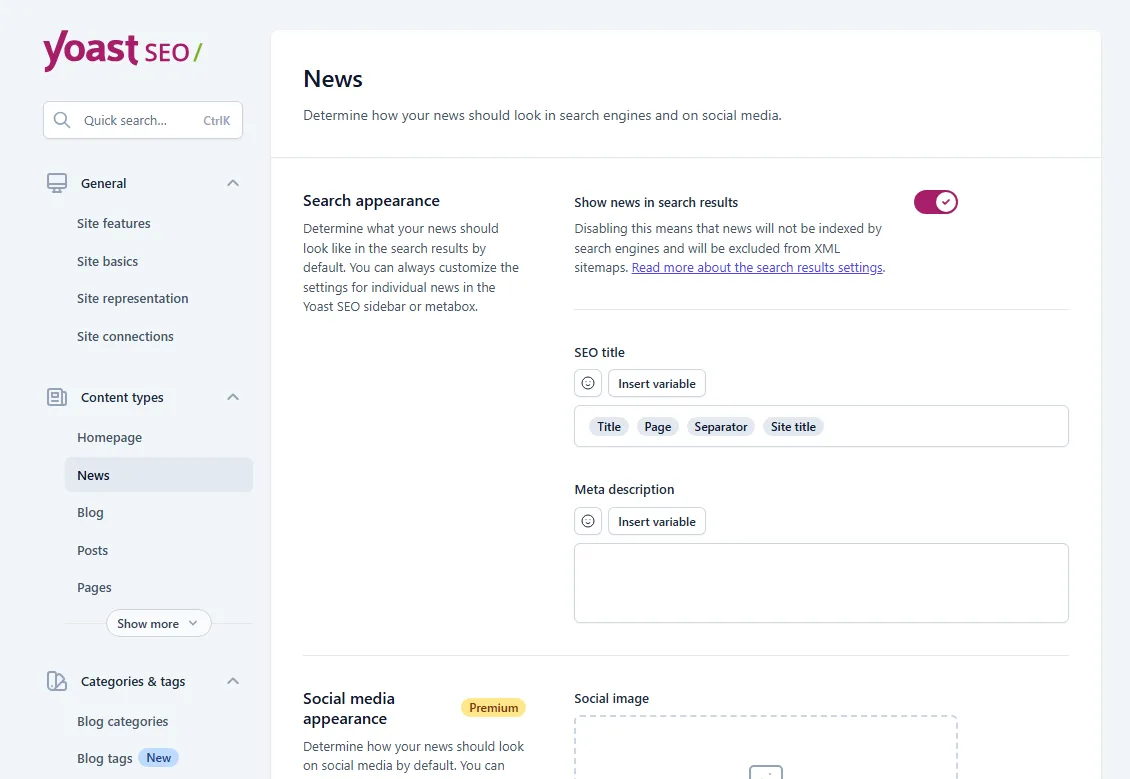
در Yoast SEO، تنظیمات مشابهی وجود دارد اما با چیدمان متفاوت:
- از پنل وردپرس وارد Yoast SEO → Search Appearance شوید
- در تبهای Content Types، Media و Taxonomies میتوانید تنظیمات پیشفرض Index/Noindex را مشخص کنید
تنظیم Robot Meta برای تکتک صفحات در Yoast
برای تنظیم دستی هر صفحه:
- وارد ویرایش پست یا صفحه شوید
- در باکس Yoast SEO، روی آیکون چرخدنده (Advanced) کلیک کنید
- گزینه Allow search engines to show this page in search result? را روی No تنظیم کنید (معادل noindex)
- گزینه Should search engines follow links on this page? را بر اساس نیاز تنظیم کنید
تنظیمات پیشرفته (Advanced Settings)
Yoast همچنین در بخش Settings → Advanced امکان تنظیم موارد زیر را میدهد:
- Noindex کردن صفحات آرشیو تاریخ
- Noindex کردن صفحات نویسنده (در سایتهای تکنویسنده)
- مدیریت breadcrumbs که به طور غیرمستقیم روی سئو تأثیر دارد
مقایسه RankMath و Yoast: کدام بهتر است؟
| ویژگی | RankMath | Yoast SEO |
|---|---|---|
| رابط کاربری Robot Meta | ساده و مستقیم (چکباکس) | نیاز به باز کردن Advanced |
| تنظیمات پیشفرض Post Types | دقیق و قابل تفکیک | مشابه اما محدودتر در نسخه رایگان |
| ویرایشگر robots.txt داخلی | دارد | دارد |
| مناسب برای ووکامرس | پشتیبانی خوب | پشتیبانی خوب (نیاز به تنظیم بیشتر) |
جمعبندی: هر دو افزونه ابزارهای قدرتمندی برای مدیریت Robot Meta هستند. RankMath معمولاً رابط کاربری سادهتری دارد، در حالی که Yoast به دلیل سابقه طولانی، مستندات بیشتری در وب فارسی و انگلیسی دارد. انتخاب نهایی به ترجیح شخصی و سایر امکانات مورد نیاز شما بستگی دارد.
اشتباهات رایج در تنظیم Robots.txt و راهحلها
بسیاری از مدیران سایت به دلیل عدم شناخت کافی از robots.txt، اشتباهاتی مرتکب میشوند که میتواند سئوی سایت را به شدت آسیب بزند.
۱. بلاک کردن کل سایت به اشتباه
User-agent: *
Disallow: /
این تنظیم به معنای بلاک کردن کل سایت است. متأسفانه این یکی از رایجترین اشتباهات است که معمولاً در حین توسعه سایت اتفاق میافتد و فراموش میشود برداشته شود.
راهحل: همیشه بعد از انتقال سایت از حالت توسعه به محیط اصلی، فایل robots.txt را بررسی کنید و مطمئن شوید خط Disallow: / حذف شده است.
۲. مسدود کردن فایلهای CSS و JavaScript
Disallow: /wp-content/این دستور تمام محتوای پوشه wp-content شامل تمها، افزونهها، CSS و JS را بلاک میکند. گوگل برای رندر صحیح صفحه به این فایلها نیاز دارد و بلاک کردن آنها میتواند به تجربه کاربری و سئو آسیب برساند.
راهحل: فقط پوشههای خاص را بلاک کنید:
Disallow: /wp-content/plugins/
Disallow: /wp-content/themes/
اما فایلهای استاتیک را آزاد بگذارید.
۳. تضاد بین robots.txt و robot meta
اشتباه: بلاک کردن صفحهای در robots.txt و همزمان استفاده از noindex در همان صفحه.
مثال: صفحه /cart/ را در robots.txt بلاک کردهاید و در همان صفحه تگ noindex گذاشتهاید. در این حالت گوگل نمیتواند تگ noindex را ببیند چون اصلاً به صفحه دسترسی ندارد.
راهحل: اگر میخواهید صفحهای Index نشود، فقط از noindex استفاده کنید و آن را در robots.txt بلاک نکنید. robots.txt را برای پوشههایی مثل wp-admin و فایلهای سیستمی نگه دارید.
۴. فراموش کردن تست بعد از تغییرات
بسیاری از مدیران سایت بعد از ویرایش robots.txt، فایل را تست نمیکنند و ممکن است خطاهای syntax یا بلاک شدن صفحات مهم متوجه نشوند.
راهحل: همیشه بعد از هر تغییر، فایل را با ابزار Google Search Console تست کنید (توضیح کامل در بخش بعد).
۵. عدم استفاده از Sitemap در robots.txt
بسیاری فراموش میکنند مسیر sitemap را در robots.txt معرفی کنند. این کار به گوگل کمک میکند سریعتر صفحات جدید را کشف کند.
راهحل: همیشه این خط را در انتهای فایل اضافه کنید:
Sitemap: https://yoursite.com/sitemap_index.xmlدستور بالا را با تغییر yoursite.com به آدرس دامنه خود میتوانید به صورت مستقیم به robots.txt سایت خود اضافه کنید. به صورت پیشفرض افزونههای Yoast SEO و RankMath این خط را اضافه میکنند.
۶. بلاک کردن پارامترهای ضروری
در ووکامرس، برخی پارامترهای URL برای عملکرد صحیح سایت ضروری هستند. مثلاً:
Disallow: /?این دستور تمام URLهای دارای Query String را بلاک میکند که میتواند برخی ویژگیها (مثل add-to-cart در ووکامرس) را مختل کند.
راهحل: فقط پارامترهای خاص را بلاک کنید:
Disallow: /*?orderby=
Disallow: /*?filter_
چطور تنظیمات Robots.txt را تست کنیم؟
استفاده از Google Search Console
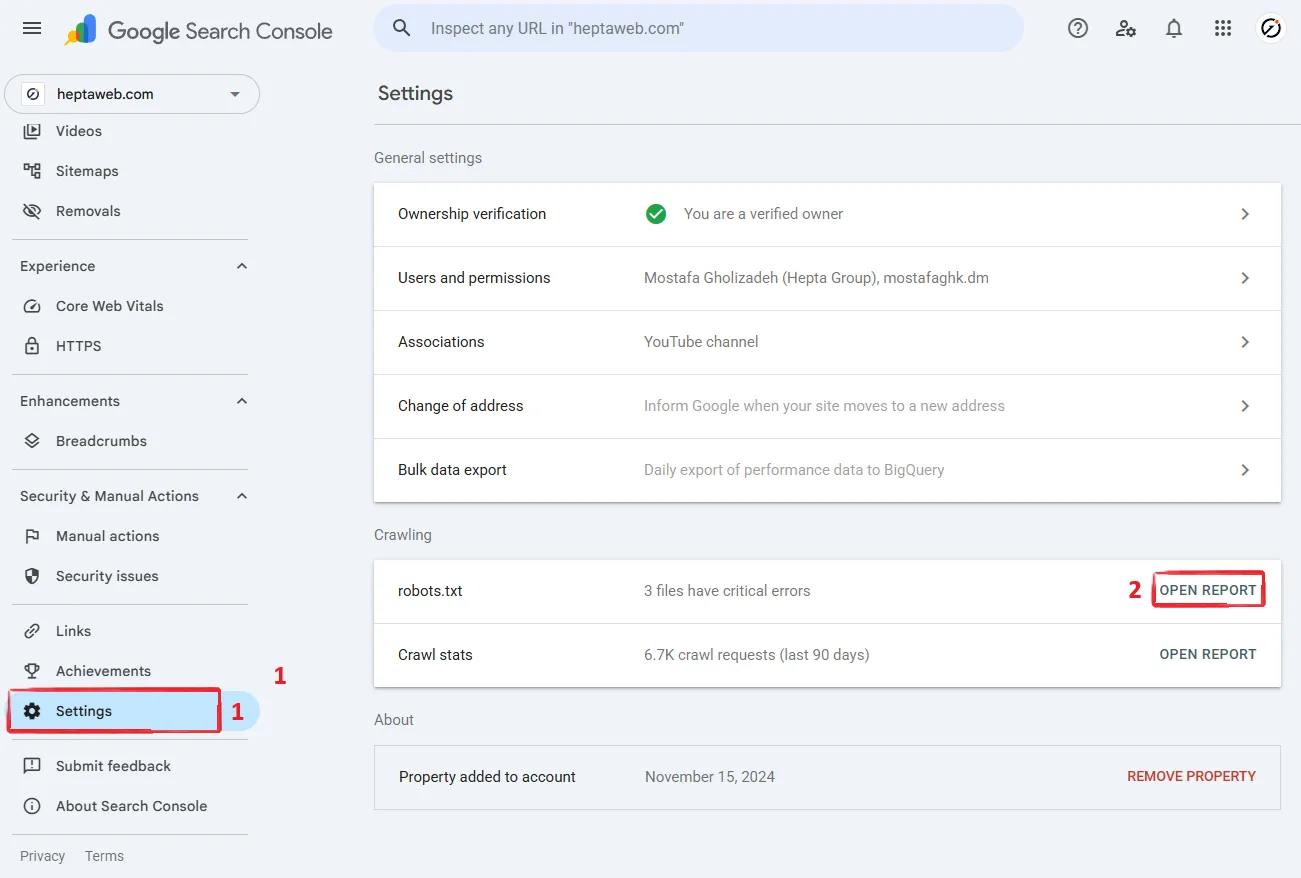
Google Search Console بهترین ابزار برای تست robots.txt است:
- وارد Google Search Console شوید
- سایت خود را انتخاب کنید
- از منوی سمت چپ وارد Settings شوید
- روی عبارت Open Report مربوط به robots.txt کلیک کنید
- لیست فایل(های) robots.txt مربوط به دامنه شما نمایش داده میشود.
- اگر در ستون Status عبارتی غیر از Fetched نوشته شده بود، احتمالا نیاز به Recrawl کردن مجدد فایل وجود دارد.
- بعد از بررسی آدرس فایل robots.txt کافیست روی منوی سمت راست هر آدرس کلیک کنید و Request a Recrawl را بزنید.
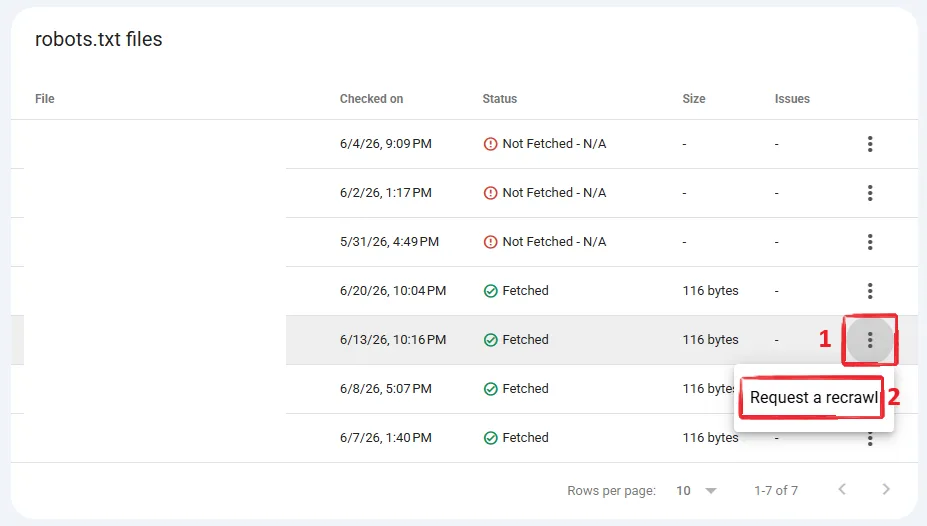
نکته: این ابزار به شما نشان میدهد که آیا فایل robots.txt سایت شما توسط رباتهای گوگل قابل شناسایی است یا خیر.
بررسی Crawl Stats در Search Console
برای مشاهده اینکه گوگل چگونه سایت شما را کرال میکند:
- در Google Search Console وارد Settings → Crawl Stats شوید
- نمودارهای مربوط به تعداد درخواستها، حجم دانلود و زمان پاسخ سرور را بررسی کنید
- اگر تعداد درخواستها به طور ناگهانی کاهش یافته، ممکن است robots.txt بخشی از سایت را بلاک کرده باشد
استفاده از ابزار Robots.txt Tester آنلاین
ابزارهای دیگری مثل Screaming Frog SEO Spider یا Sitebulb و همچنین Ahrefs نیز امکان بررسی robots.txt را دارند، اما Google Search Console رایگان و دقیقترین گزینه است. لیست برخی از ابزارهای آنلاین جهت تست دستورات ثبت شده داخل فایل:
- robots.txt Validator and Testing Tool | TechnicalSEO.com (رایگان)
- robots.txt Tester Tool (رایگان)
- Robots.txt Tester & Validator | Find & Fix SEO Issues (مربوط به افزونه رنکمث، نیاز به تحریم شکن)
بهترین شیوههای استفاده از Robots.txt و Robot Meta
برای اینکه از تنظیمات robots.txt و robot meta به بهترین شکل استفاده کنید، این نکات را رعایت کنید:
- برای صفحات حساس از noindex استفاده کنید، نه Disallow: اگر میخواهید صفحهای Index نشود (مثل Checkout)، فقط از noindex استفاده کنید تا گوگل بتواند تگ را ببیند.
- همیشه مسیر Sitemap را در robots.txt معرفی کنید: این کار کرال را سریعتر و کارآمدتر میکند.
- پوشههای سیستمی را بلاک کنید: wp-admin, wp-includes و فایلهای اجرایی PHP را از کرال خارج کنید.
- صفحات تکراری را noindex کنید: صفحات فیلتر، مرتبسازی و جستجوی داخلی باید noindex شوند تا از duplicate content جلوگیری شود.
- Crawl Budget را مدیریت کنید: سایتهای بزرگ باید مطمئن شوند که گوگل زمان خود را روی صفحات مهم صرف میکند، نه صفحات بیارزش.
- تست مداوم انجام دهید: بعد از هر تغییر اساسی در ساختار سایت یا افزودن محتوای جدید، robots.txt و وضعیت Index را بررسی کنید.
- از تضاد بین robots.txt و noindex اجتناب کنید: هیچگاه صفحهای را همزمان در robots.txt بلاک و noindex نکنید.
- برای فروشگاههای ووکامرس دقت بیشتری کنید: صفحات سبد خرید، حساب کاربری و checkout باید noindex شوند، نه بلاک.
- فایلهای استاتیک (CSS, JS, تصاویر) را باز بگذارید: گوگل برای رندر صحیح صفحه به این فایلها نیاز دارد.
- از ابزارهای سئو مثل RankMath یا Yoast کمک بگیرید: این افزونهها به شما کمک میکنند تنظیمات را بدون خطا انجام دهید.
خلاصه کل مقاله برای یادداشت
مدیریت صحیح robots.txt و Robot Meta Tags یکی از پایهایترین اما مهمترین بخشهای سئوی فنی است. با درک تفاوت این دو ابزار و استفاده صحیح از آنها میتوانید کنترل کاملی روی نحوه کرال و ایندکس شدن صفحات سایت خود داشته باشید.
چکلیست عملیاتی:
- ✅ فایل robots.txt خود را بررسی کنید و مطمئن شوید کل سایت بلاک نشده است
- ✅ صفحات حساس ووکامرس (سبد خرید، Checkout) را noindex کنید
- ✅ مسیر Sitemap را در robots.txt معرفی کنید
- ✅ تضاد بین robots.txt و noindex را بررسی و رفع کنید
- ✅ تنظیمات را با ابزار robots.txt Tester در Google Search Console تست کنید
اگر تا امروز فایل robots.txt سایت خود را بررسی نکردهاید، همین حالا وارد Google Search Console شوید و وضعیت آن را چک کنید. این یک اقدام ساده اما تأثیرگذار برای بهبود سئوی سایت شماست.
سؤالات متداول
فایل robots.txt کجا قرار دارد؟
فایل robots.txt همیشه در ریشه دامنه سایت شما قرار دارد و از طریق آدرس yoursite.com/robots.txt قابل مشاهده است. در وردپرس، این فایل به صورت خودکار توسط سیستم یا افزونههای سئو مثل RankMath و Yoast تولید میشود.
آیا باید حتماً فایل robots.txt داشته باشیم؟
داشتن فایل robots.txt الزامی نیست، اما به شدت توصیه میشود. بدون این فایل، موتورهای جستجو تمام بخشهای سایت شما را کرال میکنند که میتواند باعث هدر رفتن Crawl Budget و ایندکس شدن صفحات غیرضروری شود.
تفاوت Disallow و Noindex چیست؟
Disallow در فایل robots.txt مانع از کرال شدن صفحه توسط ربات میشود، اما اگر صفحه از راه دیگری (مثل بکلینک) شناخته شود، ممکن است بدون محتوا در نتایج جستجو ظاهر شود. Noindex در robot meta tags صراحتاً به گوگل میگوید که صفحه را در نتایج نمایش ندهد، حتی اگر کرال شده باشد.
چطور بفهمیم فایل robots.txt ما مشکل دارد؟
با استفاده از ابزار robots.txt Tester در Google Search Console میتوانید بررسی کنید که آیا URLهای مهم سایت شما به اشتباه بلاک شدهاند یا نه. همچنین کاهش ناگهانی در Crawl Stats میتواند نشانهای از مشکل باشد.
آیا میتوان robots.txt را در وردپرس ویرایش کرد؟
بله. میتوانید از طریق افزونههای سئو مثل RankMath یا Yoast SEO (بخش File Editor یا Tools)، مستقیماً فایل robots.txt را ویرایش کنید. همچنین میتوان با دسترسی FTP یا File Manager هاست، فایل را به صورت دستی ویرایش کرد.
آیا میتوانیم هم robots.txt و هم robot meta استفاده کنیم؟
بله، اما باید دقت کنید که این دو ابزار در تضاد با هم قرار نگیرند. برای بلاک کردن دسترسی به پوشههای سیستمی از robots.txt و برای کنترل ایندکس شدن صفحات خاص از noindex استفاده کنید.
چه صفحاتی را باید Noindex کنیم؟
معمولاً صفحات زیر باید noindex شوند: صفحه سبد خرید، صفحه Checkout، صفحه Thank You، نتایج جستجوی داخلی، صفحات فیلتر و مرتبسازی محصولات، و صفحات ورود/ثبتنام کاربران.


